
マイクロソフトは、2027年に新しい人工知能システム「Maia 300」のマルチギガワット規模の展開を開始する計画で、自社製品やサービス全体でAI推論の主要エンジンとして自社製シリコンを採用するにあたり、100万個以上のカスタムアクセラレータを設置する可能性がある。 ロイター通信は、マイクロソフトのAIコンピューティングの大部分を汎用グラフィックスプロセッサから、自社ワークロード向けに設計されたハードウェアへと移行させることになる。
同社は月曜日、96個のアクセラレータを搭載したMaia 300ラックは、「主要なGPUベースのシステム」よりもメガワットあたりのトークン数が40%多く、前モデルのMaia 200のラック規模でのトークン処理能力は最大7倍になると発表した。これらはマイクロソフトの予測であり、独立機関による検証済みのベンチマークではない。同社は40%の比較に使用した競合システムを明らかにしておらず、製品展開は来年まで開始されない。.
今回の発表が重要なのは、推論(訓練済みモデルを実行して質問に答えたり、コードを書いたり、一連のタスクを実行したりする作業)が、商用AIにおける継続的なコストセンターになりつつあるからだ。マイクロソフトは、こうしたハードウェアをより多く制御することで、Copilot、GitHub、Foundry、そして自社モデルのサービス提供における経済性を向上させつつ、NvidiaやAMDのアクセラレータへの依存度を低減しようとしている。.
推論を中心としたシステム
Maia 300は、従来のGPUの単なる代替品として提示されているわけではありません。マイクロソフトの 製品説明 によると、Maia 300は、長いコンテキスト、迅速な対話応答、および持続的な複数ステップのエージェント処理に対応する推論優先設計となっています。高帯域幅のHBM4メモリを8スタック搭載し、各アクセラレータは950ワットの熱設計電力内で、288ギガバイトの容量と毎秒18テラバイトのピーク帯域幅を実現しています。
この設計では、演算機能、メモリ制御機能、入出力機能をチップレットに分離している。演算ダイには台湾積体電路製造(TSMC)のN2Pプロセスが用いられ、その他のコンポーネントは帯域幅、接続性、コストなどに応じて製造方法が選択される。この分割により、マイクロソフトは最も効率向上が見込まれる処理に最先端のシリコンを優先的に投入できる。.
データ転送がエンジニアリングにおける中心的な目標です。マイクロソフトの 技術解説 によると、このチップはソフトウェア主導のデータフローと非均一なメモリレイアウトを採用し、必要な情報をプロセッサの近くに保持します。低精度フォーマットを用いることで、生成されるトークンごとに転送されるバイト数をさらに削減します。このアプローチは、推論における一般的なボトルネック、すなわち、モデルパラメータと保存されたコンテキストをコンピューティングユニットに十分な速さで供給し、ユニットを常に稼働状態に保つという課題に対処するために設計されています。
ラックが競技の単位となる
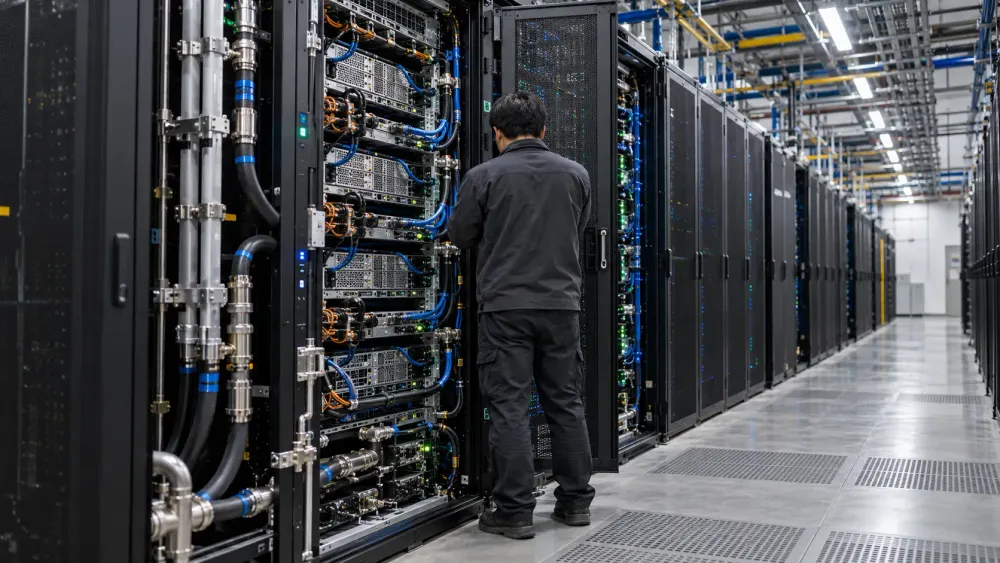
Maia 300ラックは、24個の液冷トレイに96個のアクセラレータを搭載し、最大167キロワットの電力を消費します。ラック全体では、27.6テラバイトの高帯域幅メモリと、毎秒1.7ペタバイトのメモリ帯域幅を実現しています。マイクロソフトによると、液冷システムによってラックの熱負荷の80%以上が軽減され、負荷の低いコンポーネントは通常の空冷システムで冷却されるとのことです。.
ネットワークも同様に重要です。ラック1つで1つのポッドを構成し、最大128台のラックを連結して12,288台のアクセラレータからなる「スーパーポッド」を構築できます。マイクロソフトはイーサネットベースのトランスポートとラック間で共通の通信モデルを採用することで、大規模なジョブを複数のハードウェアにまたがって処理しても、すべての転送を個別のホストシステムを経由させる必要がありません。そのため、Maia 300は単なるチップではなく、データセンターアーキテクチャとしての側面も持ち合わせています。.
167キロワットという数値は、ロイターが72個のGPUを搭載したNvidia GB300ラックについて挙げた約142キロワットよりも高い。マイクロソフトの主張は、ラックの消費電力の低減ではなく、単位電力あたりの出力に基づいている。電力会社やデータセンター運営者が電力網の接続制約に直面する中で、この違いは極めて重要だ。高密度ハードウェアは、固定された電力配分内で実行される追加のコンピューティングが各ラックの負荷増加を相殺する場合にのみ価値を生み出す。.
マイクロソフトはAI関連の継続的なコストを管理しようとしている
マイクロソフトは既にCopilotおよび社内モデル開発向けにMaia 200を本番環境で運用しており、GitHub CopilotとMicrosoft Foundryもこれに続くと予想されている。The Vergeの報道による と、Maia 300はマイクロソフトのサービスにおける主要な推論システムとなることを目指しており、限定的な社内アクセラレータープログラムよりもはるかに広範な役割を担うことになるという。
このタイミングは、需要と支出の両方の圧力を反映している。マイクロソフトは最新の 決算発表、四半期の設備投資額が410億ドルに達したと報告しており、その約3分の2はCPUやGPUといった耐用年数の短い資産に充てられている。同社は、会計上のリース再分類後、2026暦年の設備投資額は約1750億ドルになると見込んでいる一方、Azureの需要は供給能力を上回り続けている。
カスタムシリコンを採用しても、外部サプライヤーを排除できるわけではありません。マイクロソフトは依然として多様なAzureプラットフォームを提供しており、大量のGPUを購入し続けています。同社の戦略は、柔軟性や互換性が重要な場面では購入済みのハードウェアを確保しつつ、予測可能で大量の内部推論処理はMaiaに振り向けることです。利用率が高い場合、ソフトウェア、ネットワーク、シリコンを包括的に制御することで、トークンあたりのコストを削減し、単一のアクセラレータベンダーへの依存度を低減できます。.
これらの主張には、現実世界での証拠がまだ必要だ。
最も重要な数値は、将来を見据えたものです。マイクロソフトは、ワークロードごとの結果、取得コスト、故障率、または特定の競合システムとの監査済み比較を公表していません。Maia 200と比較して7倍のスループットは、ラックあたりのアクセラレータ数が2倍、帯域幅の向上、新しい高精度フォーマット、より高い電力容量など、複数の変更を組み合わせたものであり、単純なチップ間の性能測定ではありません。.
数百万チップ規模での展開は、製造、メモリ供給、ネットワーク、冷却といったリスクも伴います。TSMCの高度なプロセス能力とHBM4の供給能力は、マイクロソフトがシステムを構築するスピードに影響を与え、ソフトウェアのサポート状況は、新しいアーキテクチャ全体でモデルが効率的に動作するかどうかを左右します。設計段階で優れた性能を発揮する設計であっても、利用率の低さ、スケジューリングのオーバーヘッド、あるいは未成熟なツールによって、生産能力が損なわれる可能性があります。.
展開によって何がテストされるのか
Maia 300は、カスタムアクセラレータの実験段階から、それらをコアインフラストラクチャへと移行させるという戦略的な転換点となる。2027年の展開では、モデル選択やサービスの信頼性を損なうことなく、アーキテクチャ制御を、有用なAI応答あたりのコストと消費電力の測定可能な削減に結びつけることができるかどうかを検証する。.
最も明確な証拠は、生産開始後に明らかになるだろう。具体的には、利用率、顧客対応状況、比較可能なパフォーマンスデータ、そしてマイクロソフトの推論トラフィックのうちMaiaに移行された割合などが挙げられる。現時点では、今回の発表は計画規模と技術的方向性を示すものであり、マイクロソフトがその規模を正当化すると述べている効率性上の優位性を証明するものではない。.











